Sitemap 還有用嗎?Google 第 114 集 Podcast 全解析:哪些欄位已被放棄、AI 爬蟲怎麼找到你、「Couldn’t fetch」其實在說什麼
一個讓很多人皺眉的紅字
你有沒有遇過這種情況?sitemap.xml 用驗證工具檢查,格式完全正確,瀏覽器打開沒問題,robots.txt 也寫了。你把它丟進 Search Console,幾分鐘後跳出紅色的「Couldn't fetch」(無法擷取)。
很多人接下來會重新產生檔案、換外掛、改檔名,再送一次,然後再看到一次紅字。我自己也這樣折騰過,那種感覺就是明明沒做錯事,卻被判了一個看不懂的罪。
2026 年 10 月 1 日,Google 的 John Mueller 與 Martin Splitt 在《Search Off the Record》第 114 集「Do sitemaps still matter?」把這個問題攤開來講。這集約 26 分鐘,Google 同時公開了逐字稿。Search Engine Journal 的兩篇報導各抓了一個重點:一篇談 AI 爬蟲怎麼找到你的 sitemap,一篇談那個錯誤訊息。其他媒體則整理了節目裡談到的欄位與規格。
這篇文章把這些資料合在一起,再補上我查到的外部數據,最後比較各方立場的差異。
先說明一件事:這集節目的細節,我是透過 SEJ、Relevant Audience、PPC Land 等報導取得,不是自己聽完整集。要引用原話時,請以 Google 的逐字稿為準。
先看歷史:為什麼會有 sitemap
Mueller 在節目裡回顧,sitemap 大約有 20 年歷史,當年的構想是和 Microsoft、Yahoo 一起分享,最後成為幾家公司都同意的半標準。他自己曾做過一個 Windows 上的 sitemap 產生器,後來因此進了 Google。
原始目的很單純:那時網站結構混亂、很難爬,站長提供一份網址清單,附上更新日期與優先順序,搜尋引擎就知道該把力氣放在哪,同時仍會自己爬,避免遺漏。接下來的問題是,這套設計裡哪些部分到現在還成立?
重點一:哪些欄位還有用,哪些已經被放棄
| sitemap 元素 | |
|---|---|
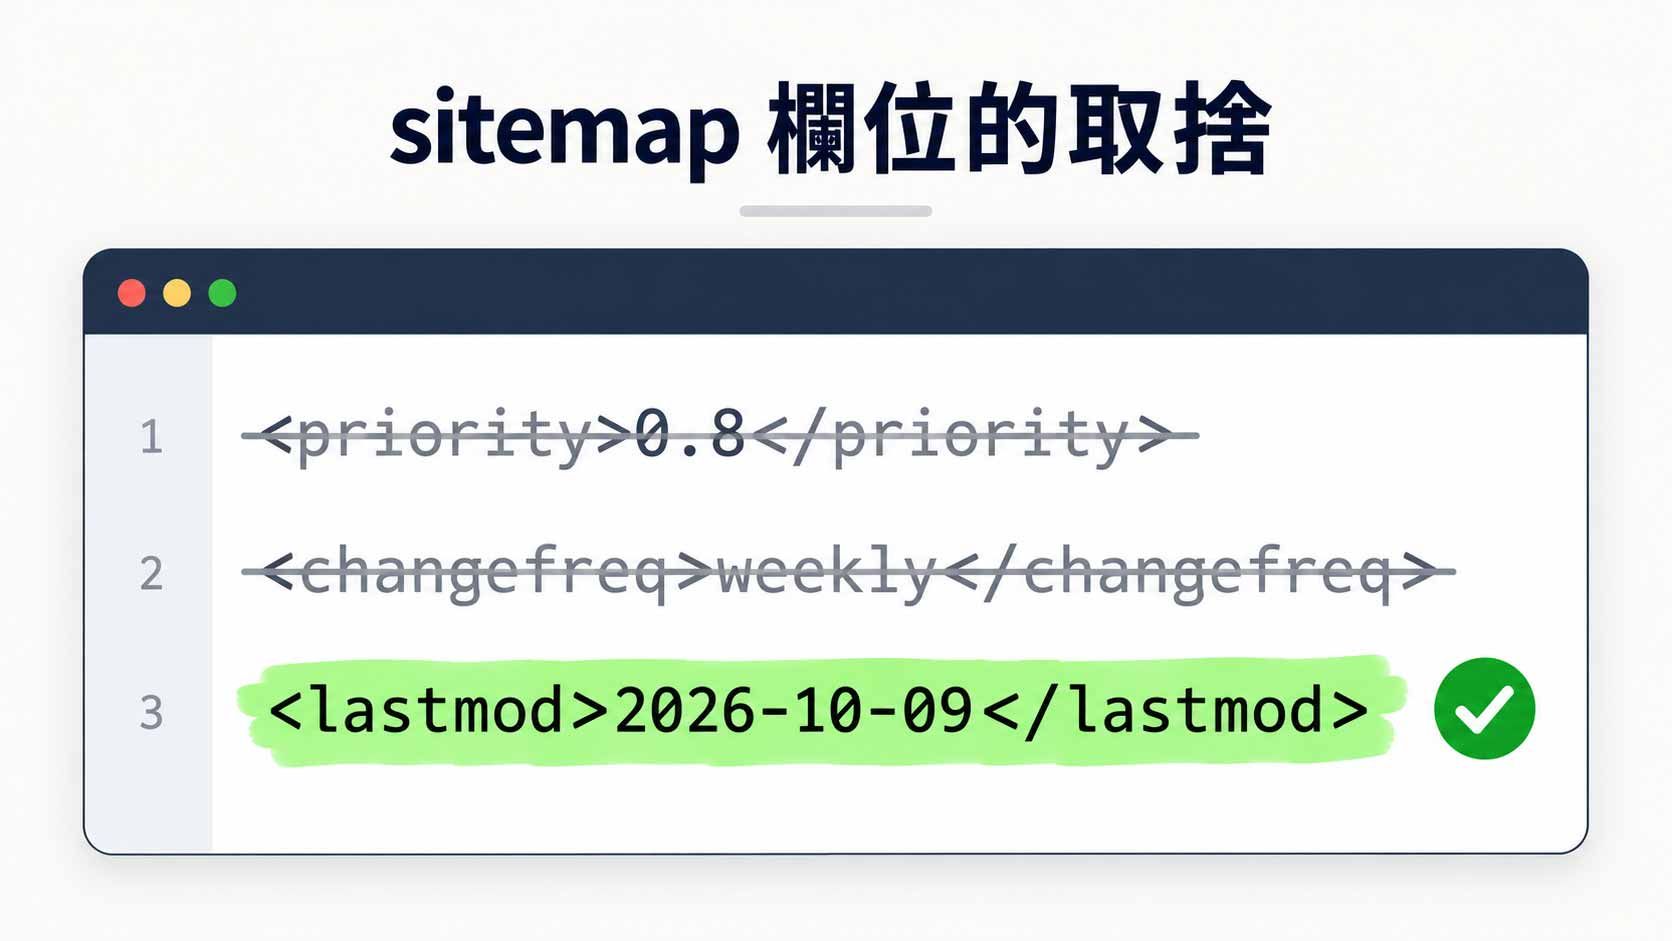
| priority | 已放棄。大家都把每個網址標成最高優先,所以沒用 |
| changefreq | 已放棄。動態網站的頁面技術上每次請求都重新產生,所以一律標成「常常更新」,沒有參考價值 |
| lastmod | 日期看起來合理時才會採用,不準就忽略;全部標成今天不算垃圾訊號,但 Google 會不再信任 |
| 網址 | 放你希望被索引的 canonical 版本,不要帶追蹤參數或時間戳記 |
| 檔案限制 | 單檔 50,000 個網址、50 MB(未壓縮);index 檔只能巢狀一層 |
Mueller 對 lastmod 的形容是「又愛又恨」:Google 想用,但太多網站填錯。如果同一個檔案裡的日期看起來合理,就會參考;不合理的話,就回到以單一網址為主的處理方式。他也提到,sitemap 會影響 canonical 的選擇:當多個相似網址被發現時,被列進 sitemap 的那個會更有機會被選為 canonical。
這裡的實務意義很具體:如果你的 CMS 每次重新產生檔案,就把所有 lastmod 改成當天,那就等於沒填。這個欄位的價值,來自它只在真正改動時才變。
重點二:小網站需不需要 sitemap
Mueller 說小型網站「大概不需要」,因為 Google 直接爬就能找到。但他也承認,網站是 10 頁還是 50 頁,站長自己很難判斷門檻,所以給了務實的建議:保持開啟。幾乎所有 CMS 和靜態託管服務都會預設產生 sitemap,留著沒有壞處,網站長大或不長大都一樣。
真正明顯受益的,是內容量不小又常常變動的網站。他舉了兩個例子:
- 新聞網站:另有專用的 news sitemap,據他的說法,出版商只需要列最近改動的約 1,000 頁。
- 電商:商品價格變動時,一般爬取可能很晚才發現,但 sitemap 若標示該頁已更新,Google 就能直接去看。
換成台灣的情境,雙 11、週年慶期間價格天天在跳的電商站,正好是 Mueller 說的那種情況。lastmod 準不準,會直接影響 Google 多快看到新價格。
重點三:AI 爬蟲沒有 Search Console,你要自己讓它們找得到
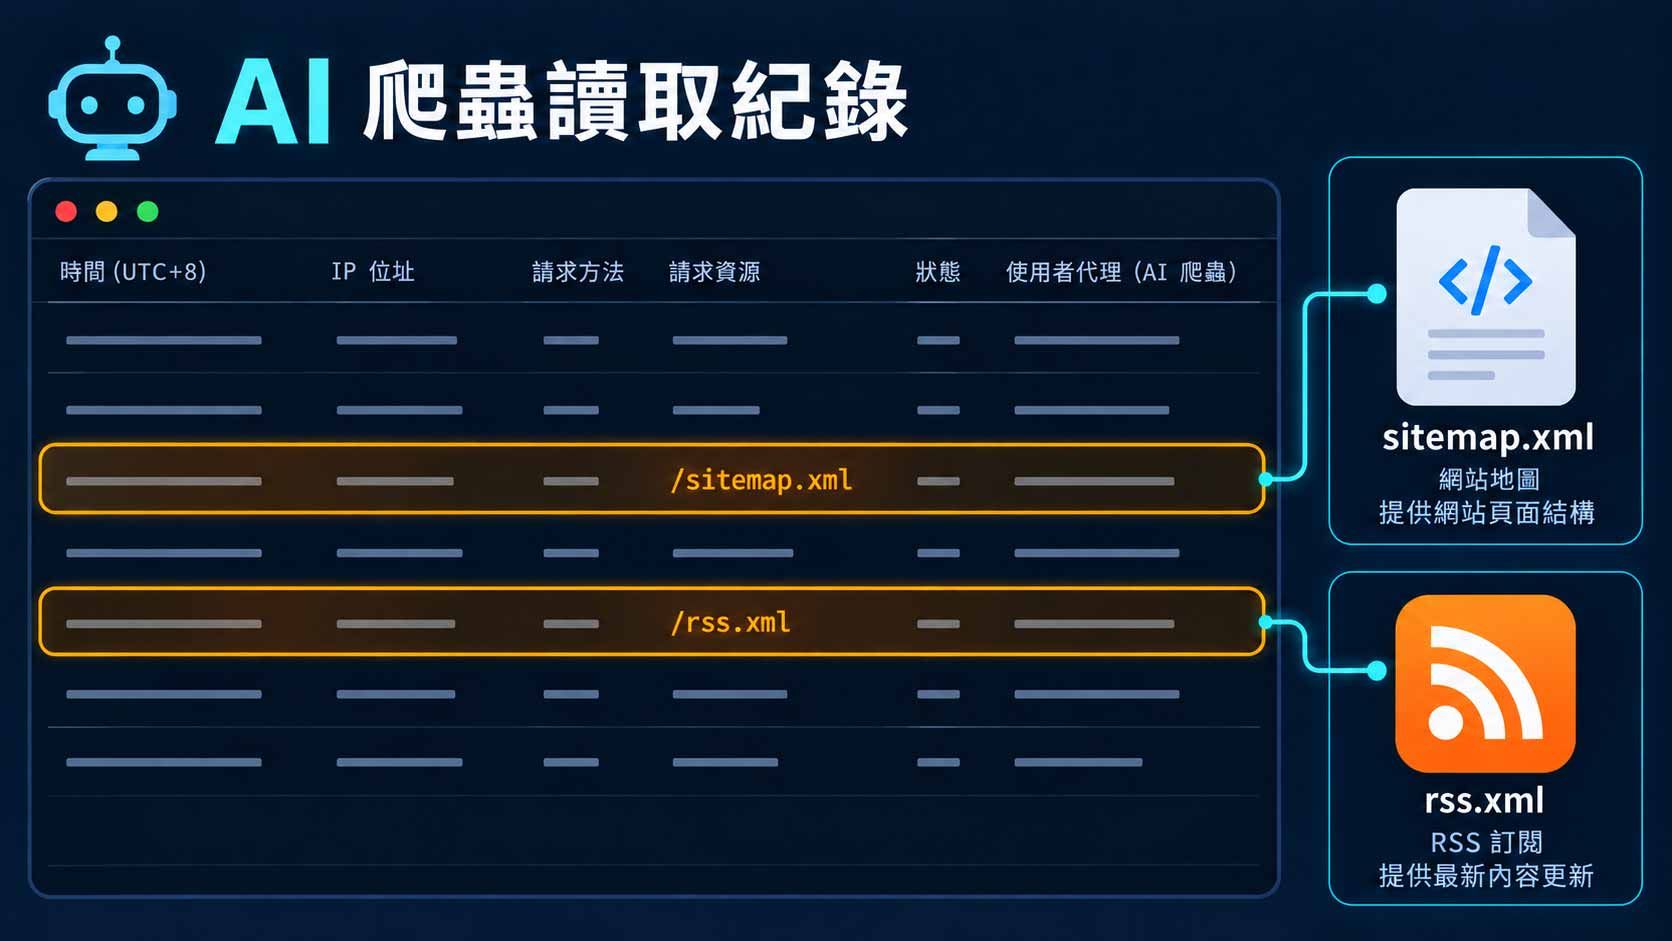
Mueller 指出,AI 訓練用的爬蟲通常沒有讓網站主提交 sitemap 的管道,這跟 Google 有 Search Console、Bing 有 Webmaster Tools 完全不同。他給的建議是:想讓內容進入 AI 系統,要嘛沿用通用檔名 sitemap.xml,要嘛把力氣放在 RSS feed 上。
為什麼是 RSS?因為 feed 通常會被連結在網頁的 HTML head 裡,爬蟲只要讀到頁面就能發現它。另外,RSS 也可以在 Search Console 當成 sitemap 提交。差別在範圍:feed 通常只列最近 10 到 20 個變動的網址並附日期,系統不需要翻完大型網站的每個 sitemap 檔,就能知道最近有什麼新東西。
Mueller 也提到,他在自己的伺服器日誌裡,看過某些 AI 爬蟲讀取他的 sitemap 檔,RSS 也一樣。但他沒有指名是哪些爬蟲,也不確定它們有沒有公開記載這件事,更不知道它們拿這些檔案做什麼。
檔名其實很自由。他說 sitemap 不一定要叫 sitemap.xml,開玩笑說可以用 Splitt 的貓來命名。想保持私密的人,可以取冷門檔名、不寫進 robots.txt,Mueller 稱這樣「完全沒問題」。代價是檔案只能直接提交給 Google,Bing 要另外提交,AI 爬蟲則大概找不到。藏起來和被找到,是同一個選擇的兩面。
重點四:llms.txt 不是 sitemap 的替代品
Splitt 問 llms.txt 能不能取代 XML sitemap,Mueller 的回答是簡單的「不行」。他把這個 Markdown 檔比作 HTML 版的網站地圖,並說 Google 的系統無法把它當 sitemap 用,因為缺少嚴格的格式。他認為期待比現實大,也說目前這些都還沒發生,只是搜尋系統將來也許會處理 Markdown。他的建議是:把力氣放在已經有文件記載、確定有效的做法上,就算 CMS 自動幫你產生了 llms.txt,也不必特別看重。
HTML sitemap 也得到類似的評價:那是給使用者看的地圖,可以像一般連結頁面被爬取,但無法當作 sitemap 檔提交,而且通常只列分類,不列每個商品。
這個立場前後一致。八月他提過,自己測試網站上唯一宣稱接受 Markdown 的爬蟲,是 SEO 工具。五月 Google 的 AI 優化指南,也把 llms.txt 列在生成式 AI 功能「不需要」的做法清單裡。
重點五:「Couldn't fetch」不一定是技術問題
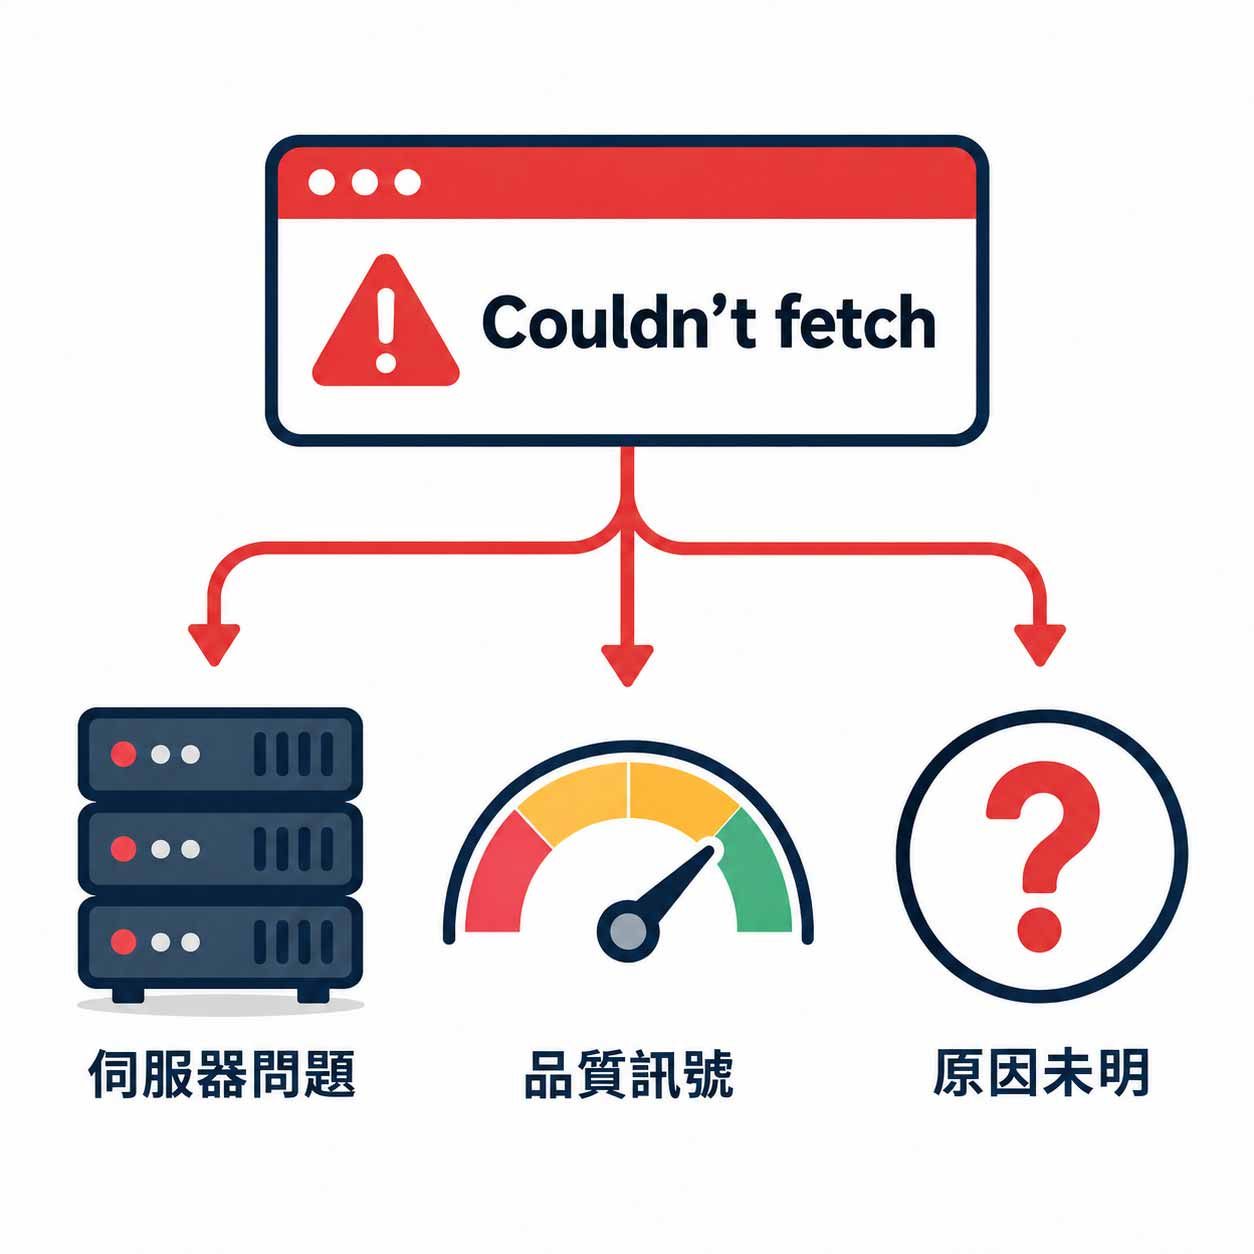
這是我覺得整集最有料的部分。Splitt 先承認,很多人的 sitemap 明明有效、公開、也寫在 robots.txt,卻還是被回報無法擷取。Mueller 說這種問題在論壇上很常見,並給了兩個主要原因,Search Engine Journal 的整理還額外歸納出第三個:
| 原因 | 意思 | 你能做什麼 |
|---|---|---|
| 主機負載(host load) | Google 系統太忙沒空取檔,或你的伺服器扛不住爬取量 | 查伺服器日誌與 Search Console 的 5xx 紀錄,改善主機效能 |
| 抓取需求(crawl demand) | Google 判斷這個網站沒必要再多抓,就先跳過 sitemap | 改善內容品質,讓系統覺得值得多花時間 |
| Google 根本不需要 | 已經抓夠了,或不想要這份檔案 | 持續提升網站整體品質,等系統改變看法 |
Mueller 說,抓取需求「很常」取決於 Google 對網站品質的觀感,所以這不純粹是技術問題。他的意思很直白:如果系統認為網站整體品質普通,就不會花力氣抓取和索引,連帶也懶得理 sitemap。品質明顯進步之後,系統才會回頭使用。
這跟他二月在 Reddit 上的說法互相呼應:Google 如果不確信有新的、重要的內容可以索引,就不會使用 sitemap。Search Console 說明頁面也把低抓取需求列為原因之一,並說更好的內容會帶來更高的抓取需求。
不同角度:同一件事,五種讀法
1. Google 的角度:sitemap 是「建議」,不是「命令」
在 Google 眼裡,系統有自己的資源分配邏輯,先看網站值不值得,再看檔案要不要用。從這個角度,「Couldn't fetch」只是一個簡化過頭的標籤。節目也沒有宣布新的文件或 Search Console 功能,它就是一場討論。
2. 批評者的角度:標籤跟事實不符,就是產品問題
Search Engine Journal 的 Roger Montti 對此相當不客氣。他指出,訊息(couldn't fetch)與實際原因不符,使用者因此困惑又挫折。更讓他不滿的是,Google 顯然知道這則訊息沒幫助,卻等於聳聳肩沒有處理。他也坦言,不太同意 Mueller 把抓取需求和主機負載連在一起講。
我比較站在這一邊。一則錯誤訊息的工作,是幫人定位問題。如果同一句話可能代表「你的伺服器掛了」,也可能代表「我們覺得你的內容不夠好」,兩者的處理方式天差地遠,那這句話幾乎等於沒說。
3. 技術 SEO 的角度:先排除能排除的,再談品質
務實派的做法是照順序來。Montti 補充了一個 Mueller 沒提的情境:深夜時各種爬蟲同時猛打網站,伺服器撐不住就回 500 錯誤,這能用 Search Console 的紀錄和伺服器日誌確認。所以我的建議是,先看日誌確認不是主機問題,再去懷疑品質。Relevant Audience 的整理也持類似看法:持續出現無法擷取時,應該先看抓取統計與內容品質,而不是只重新驗證 XML。
4. 內容經營者的角度:被「品質」兩個字戳到
很多小站長聽到「抓取需求取決於品質」會很不舒服,因為品質是主觀的,而且 Google 不會告訴你具體差在哪。這個擔心合理:品質評估沒有儀表板,你只能從索引速度、抓取頻率這些間接訊號去推測。我的看法是,這句話與其當成指控,不如當成提醒:sitemap 解決的是「發現」問題,不解決「值得」問題。
5. AI 能見度的角度:爬蟲很多,但控制權很有限
我另外查了 AI 爬蟲的整體狀況,畫面比 Mueller 的一句話複雜得多。
Cloudflare Radar 過去十二個月(2025 年 3 月到 2026 年 3 月)的資料顯示,GPTBot 與 ClaudeBot 分別占全球 bot 流量約 12% 與 9.2%。另一份整理指出,2026 年 5 月 Googlebot 是最大的單一來源,占請求量 27.26%,GPTBot 為 11.48%,ClaudeBot 為 9.73%,與 4 月的排名相反。AI 爬蟲的量體已經大到不能忽略,而且排名每個月都在變。
至於它們守不守規矩:Anthropic 表示旗下三個 bot 都遵守 robots.txt,也支援 Crawl-delay。但 Bytespider 被記錄到無視 robots.txt,並猛烈抓取網站,所以光靠 robots.txt 很難擋住它。
而「被抓」不等於「被引用」。Cloudflare 2026 年第一季的分析指出,ClaudeBot 每抓 20,583 頁才換回一次轉介,且 89.4% 的 AI 爬蟲流量用於訓練或混合用途,而非搜尋。這也解釋了為什麼不少網站選擇封鎖它們。
於是出現一個有趣的對立:Mueller 在教你怎麼讓 AI 爬蟲找到你,而另一群人在研究怎麼把它們擋在門外。兩邊都對,取決於你的內容是靠曝光賺錢,還是靠獨家內容收費。
我的看法:sitemap 沒過時,但很多人填錯了
讀完這些資料,我整理出四個判斷:
- sitemap 還是基本配備。它是幾乎所有搜尋與 AI 系統都看得懂的通用格式。Mueller 自己的立場也在變,他 2011 年曾說小網站不太需要 XML sitemap,這次的說法則是小站可以不用,但留著沒壞處。
- 真正的問題常在 lastmod。priority 和 changefreq 已經沒人看了,但很多外掛仍然預設輸出。與其煩惱這些,不如檢查 lastmod 有沒有反映真實的改動。
- 想被 AI 看見,就別玩花招。檔名用 sitemap.xml,robots.txt 寫上 Sitemap 那行,再準備一份 RSS。這三件事成本幾乎是零。
- 看到「Couldn't fetch」先別重做檔案。先查日誌,再查內容。如果兩邊都沒問題,那答案可能就是:Google 現在還不想理你。這很傷人,但至少方向是對的。
有一點要老實說:關於 AI 爬蟲讀 sitemap 這件事,目前證據只是 Mueller 個人日誌裡的觀察。他沒說是哪些爬蟲,也沒說它們如何使用。不要把它當成「所有 AI 都靠 sitemap 找內容」的結論。節目裡也沒給出小網站的頁數門檻,也沒說 Google 怎麼判斷 lastmod 算不算合理。
今天就能做的檢查清單:
- 確認 sitemap 只列 canonical 網址,沒有追蹤參數或時間戳記
- 檢查 lastmod 是否只在內容真正改動時才更新,不要每次產生檔案就全部改成今天
- 把 priority 與 changefreq 當成可有可無的欄位,不必花時間調整
- 確認單一檔案不超過 50,000 個網址與 50 MB(未壓縮),超過就拆檔並用 index 檔串起來
- 確認 sitemap 放在 /sitemap.xml,並寫在 robots.txt 最下方
- 替部落格或新聞區準備 RSS feed,確認 HTML head 裡有連結,也可以在 Search Console 當 sitemap 提交
- 打開伺服器日誌,搜尋 GPTBot、ClaudeBot、PerplexityBot,看它們有沒有讀過你的 sitemap 或 RSS
- 檢查 CDN 或 SEO 外掛是否在你不知情時封鎖了 AI 爬蟲
- 遇到「Couldn’t fetch」:先查 5xx 錯誤與伺服器負載,再回頭檢視內容品質
- llms.txt 想放就放,但別指望它取代 sitemap
常見問題
Q:Google 還在用 sitemap 的 priority 和 changefreq 嗎?
不用了。Mueller 在第 114 集說這是 Google 放棄的兩個欄位,Google 主要看網址與 lastmod 日期。
Q:把所有網址的 lastmod 都設成今天,會被處罰嗎?
不會。Mueller 說這不算垃圾訊號,但 Google 會發現這些日期沒有意義,之後就不再依賴它們。
Q:Search Console 顯示「Couldn't fetch」,是我的 sitemap 壞了嗎?
不一定。依 Mueller 的說法,可能是 Google 系統太忙、你的主機負載過高,或是 Google 認為暫時沒必要抓取你的網站,而後者常與網站品質有關。先驗證格式、查伺服器日誌,確認沒有技術問題後,再檢視內容品質。
Q:AI 爬蟲真的會讀 sitemap 嗎?
Mueller 說他在自己的伺服器日誌裡看過 AI 爬蟲存取 sitemap 與 RSS,但沒有指名是哪些爬蟲,也不確定它們如何使用。你可以用自己的日誌驗證。
Q:llms.txt 可以取代 sitemap.xml 嗎?
不行。Mueller 表示 Google 的系統無法把它當 sitemap 使用,因為缺少嚴格格式,他也建議不要特別看重它。
Q:小網站需要 sitemap 嗎?
Mueller 說大概不需要,因為 Google 可以直接爬。但他建議保持 CMS 預設產生的那份,沒有壞處。
Q:RSS 可以當 sitemap 嗎?
可以。RSS 可以在 Search Console 當 sitemap 提交,不過 feed 通常只列最近 10 到 20 個變動的網址。
最後一個問題留給你
你的網站日誌裡,有沒有出現過 GPTBot 或 ClaudeBot 的身影?你的 sitemap 裡,lastmod 是真的在記錄改動,還是每次都被洗成今天?今天花十分鐘去翻一下!
參考資料:
- Relevant Audience(Antonio Fernandez):Google's Mueller on sitemaps: lastmod, "Couldn't fetch" and llms.txt
- PPC Land:Google may skip sitemaps on sites it deems low quality
- Oncrawl:What AI bots are really doing on your site
- GeoToolbox:AI Crawlers: The List of AI Bots & How to Control Them
- Superblog:AI Crawlers Explained: GPTBot, ClaudeBot, and Who's Reading Your Site
- Technology Checker:We Analyzed robots.txt Across Cloudflare's Network(Q1 2026)